Использование контента — текста, музыки, изображений — произведенного не человеком для тренировки моделей, подобных ChatGPT, Stable Diffusion и Midjourney, приводит к необратимым дефектам в их продукте. К такому выводу пришла группа британских и канадских ученых, экспериментировавших с тренировкой моделей на контенте, который ранее произвели другие модели. Например, на текстах, произведенных ChatGPT, или изображениях, сгенерированных Midjourney. Свои выводы ученые опубликовали на портале для научных публикаций arXiv.org.
Один из авторов работы сравнил засорение интернета генеративным контентом с замусориванием океана пластиком, а атмосферы — углекислым газом. По мнению ученых, этот процесс сильно затруднит обучение новых поколений генеративных моделей — тех, которые в СМИ часто называют «искусственным интеллектом».
«Обучение на данных, сгенерированных другими моделями, вызывает коллапс модели — дегенеративный процесс, в котором с течением времени модели забывают изначальное распределение, лежавшее в основе. <…> Этот процесс необратим, даже для ситуаций с практически идеальными условиями для долговременного обучения».
По словам одного из авторов статьи, Ильи Шумайлова, ошибки в сгенерированных данных накапливаются и заставляют еще более некорректно воспринимать реальность. «Мы с удивлением обнаружили, как быстро происходит этот коллапс: модель может быстро забыть большую часть исходных данных, на которых она училась», — отметил он в письме изданию VentureBeat.
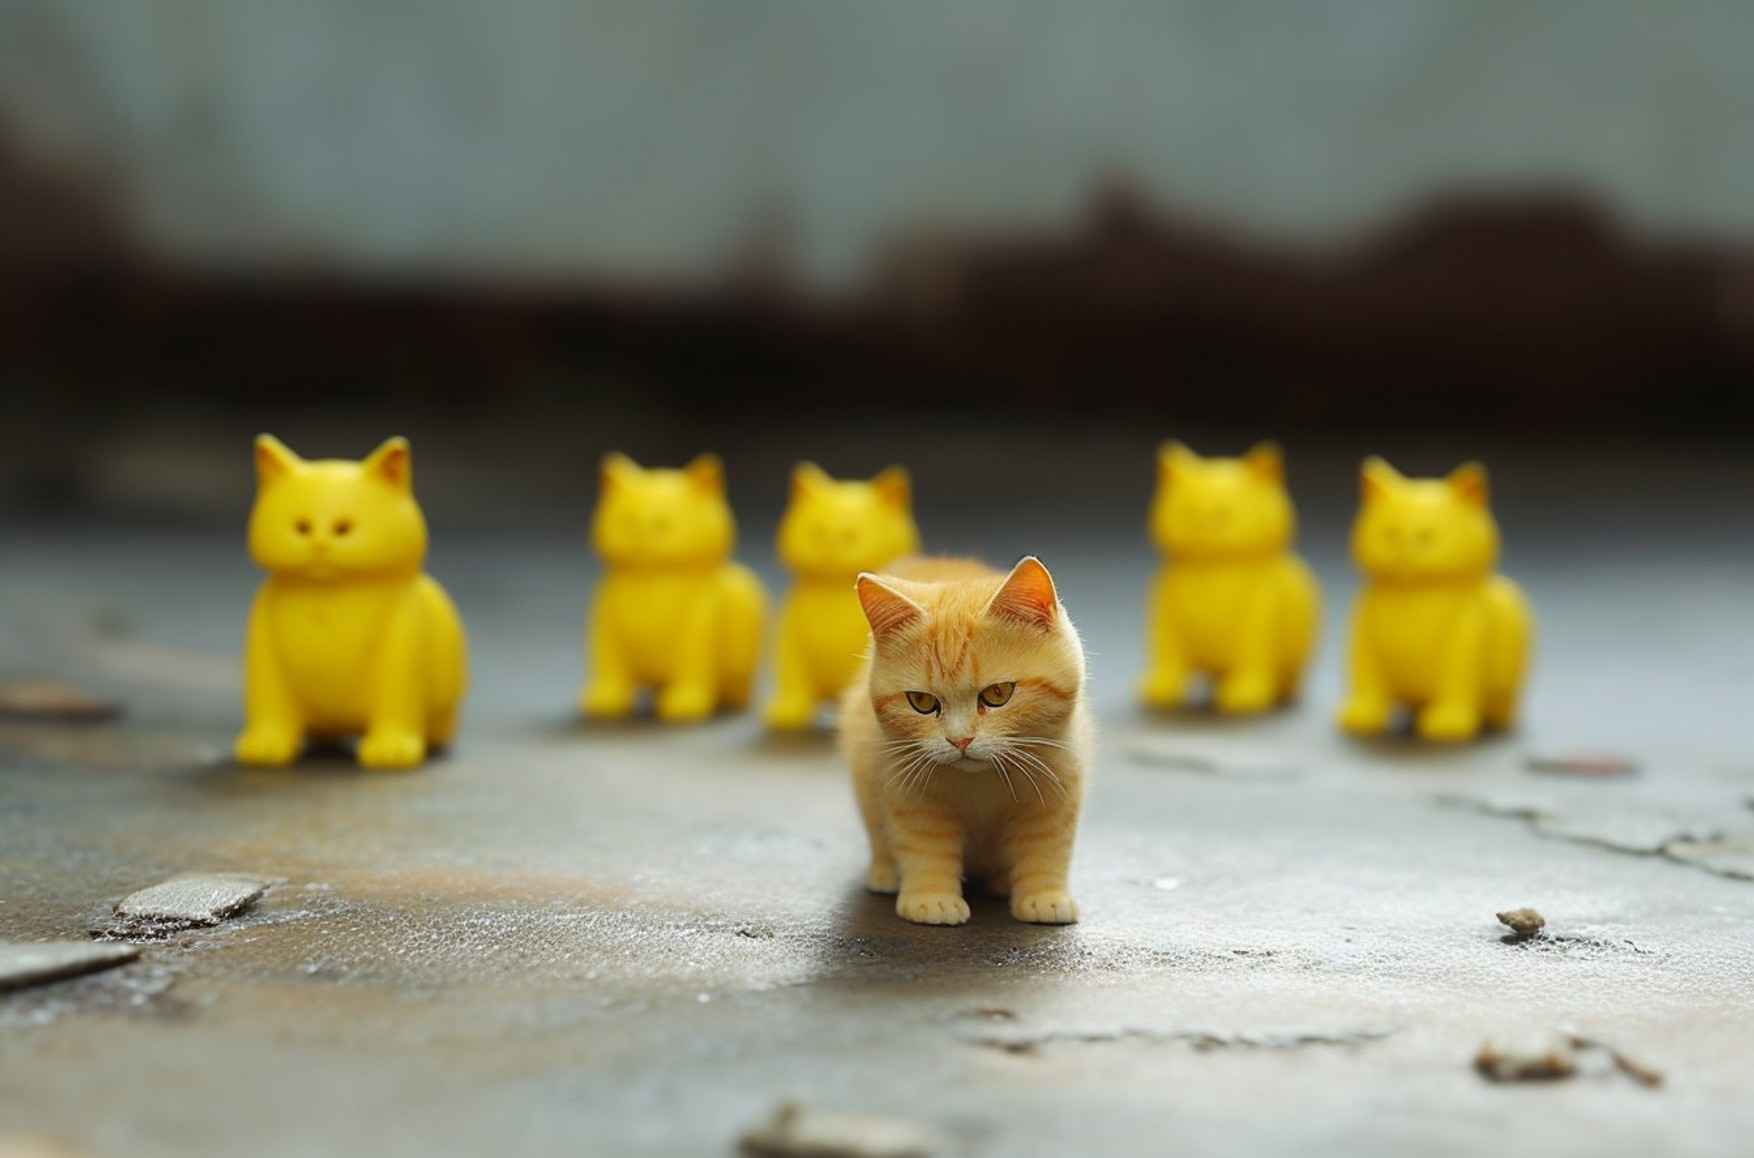
В качестве примера Шумайлов привел воображаемую ситуацию, в которой модель тренируется на 100 картинках котов, из которых 90 желтые, а 10 — голубые. Сначала модель генерирует пропорциональное число желтых и голубых котов, хотя некоторые голубые коты становятся слегка желтоватыми, затем зелеными (смешанного цвета), а затем мало-помалу признак «голубоватости» у котов стирается, и все новые сгенерированные коты будут желтыми. Таким образом, модель «забывает», какие изначальные данные были в нее заложены, и происходит это, именно когда на входе в нее подаются уже сгенерированные данные, например, фотографии котов. Не помогла даже настройка модели, в которой ей запрещалось производить слишком много аналогичных ответов: тогда вместо повторяющихся условных «желтых котов» модель производила уже абсолютно искаженные изображения, лишь бы не повторить одинаковых котов.
Илья Шумайлов отмечает, что найденный его командой феномен отличается от «катастрофического забывания», когда модель теряет изначально заданную информацию. В данном же случае модель неверно интерпретирует реальность, основываясь на том, что она посчитала правдивыми данными.
Соавтор статьи — Росс Андерсон, пионер в области инженерии безопасности, член Королевской инженерной академии и профессор персональной кафедры безопасности и компьютерной лаборатории Кембриджского университета — в своем блоге сравнил найденный командой эффект с масштабным загрязнением окружающей среды.
«Через несколько поколений [сгенерированный] текст превращается в мусор. <…> Точно так же, как мы засыпали океаны пластиковым мусором и наполнили атмосферу углекислым газом, мы скоро наполним интернет чепухой <в оригинале — blah — DisInform Watch>. Тренировать новые модели, собирая для них данные в сети, будет сложнее. Преимущество получат компании, которые сделали это раньше, или те, у кого есть доступ к пользовательскому контенту в большом объеме. <…> Большие языковые модели подобны огню: хорошая штука, но загрязняет окружающую среду».
Исследователи отмечают, что избежать коллапса модели можно, если сохранять датасеты, не загрязненные сгенерированным моделями контентом, а созданные исключительно людьми (к примеру, наборы текстов, фотографий или изображений), а также производить новые такие датасеты. Однако, как отмечает Росс Андерсон, в интернете, заваленном сгенерированным моделями контентом, делать это будет всё сложнее и сложнее. Илья Шумайлов также отмечает, что в датасетах всегда должны быть хорошо представлены меньшинства. Задачу сбора и хранения таких данных он считает довольно нетривиальной.
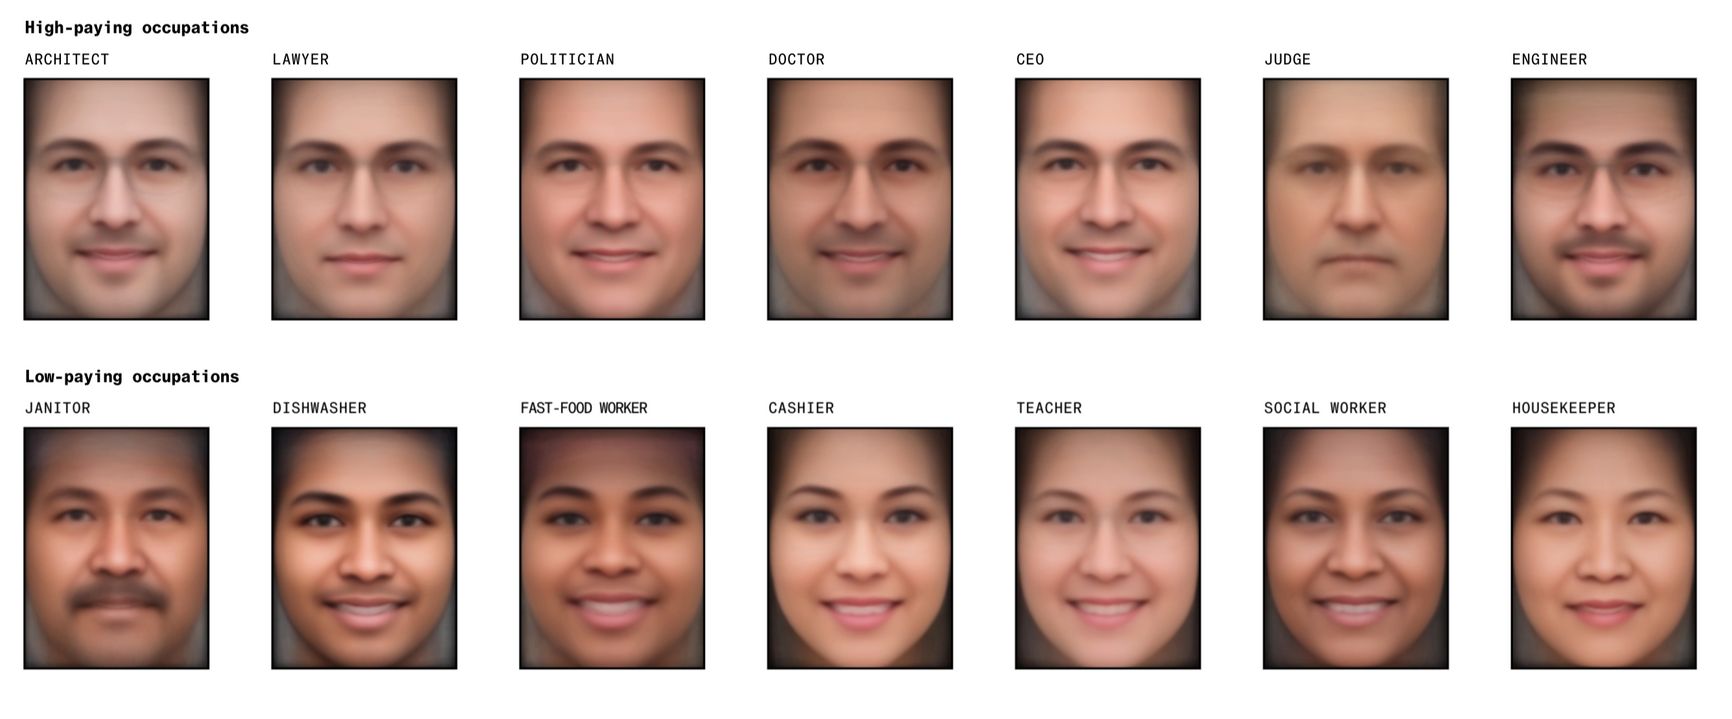
Усредненные работники разных сфер, сгенерированные Stable Diffusion
В июне Bloomberg опубликовал расследование о предрассудках генеративного искусственного интеллекта. Оказалось, что модель Stable Diffusion считает, что адвокаты, доктора и судьи — это почти всегда мужчины, руководители компаний — непременно белые мужчины, а темнокожие люди могут быть только преступниками или работать в бургерной.

Операция «мигрант»: как ФСБ организует нелегальный трафик людей через страны Балтии в ЕС
C января по конец июля 2026 года Латвийская пограничная служба предотвратила 8814 попыток нелегальных иммигрантов попасть на территорию страны. Несмотря на усиление контроля со стороны европейских погранслужб, каналы незаконной переправки людей продолжают работать. Как выяснил The Insider, через эти каналы в Евросоюз просачиваются и достигают границ Германии до 20 нелегальных иммигрантов за раз…
NYT: Страны-посредники вернули на родину более 110 мигрантов, которых суды США запретили туда высылать из-за угрозы пыток
Администрация Дональда Трампа депортирует мигрантов в третьи страны, а те отправляют их на родину — туда, куда американские суды запретили высылать этих людей из-за риска пыток, сексуального насилия или преследования. Газета The New York Times выявила более 110 таких случаев и считает эту оценку заниженной. Иностранные правительства соглашаются принимать депортированных в обмен на деньги и внеш…
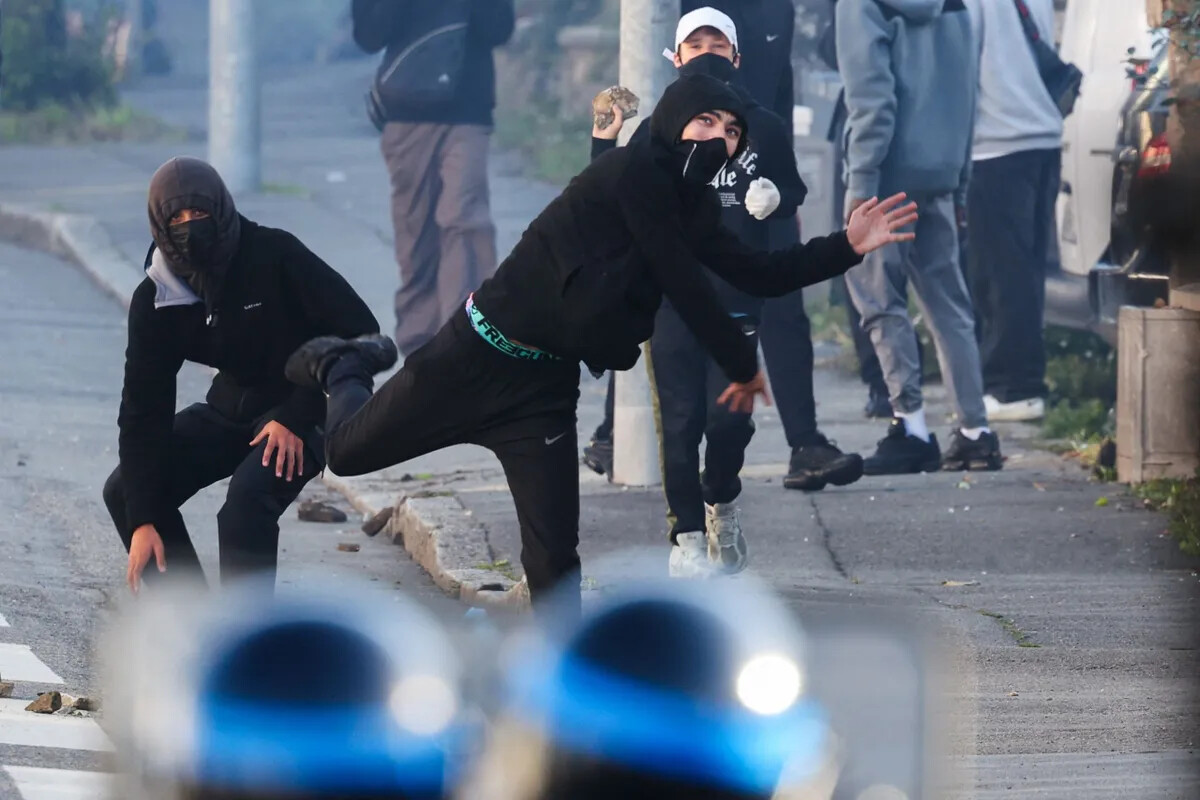
Аккаунты, связанные с Россией, Израилем и MAGA, раздували тему мигрантов на фоне беспорядков во Франции — расследование ЕС
Российская сеть тайно использовала октябрьские беспорядки во Франции, чтобы в соцсетях обвинить в них неконтролируемую миграцию и представить правительство потерявшим контроль над ситуацией. Это следует из внутренней оценки ЕС, с которой ознакомилось агентство Reuters. Отдельный документ МИД Франции показал, что «враждебные нарративы» о связи беспорядков с радикальным исламизмом и миграцией так…
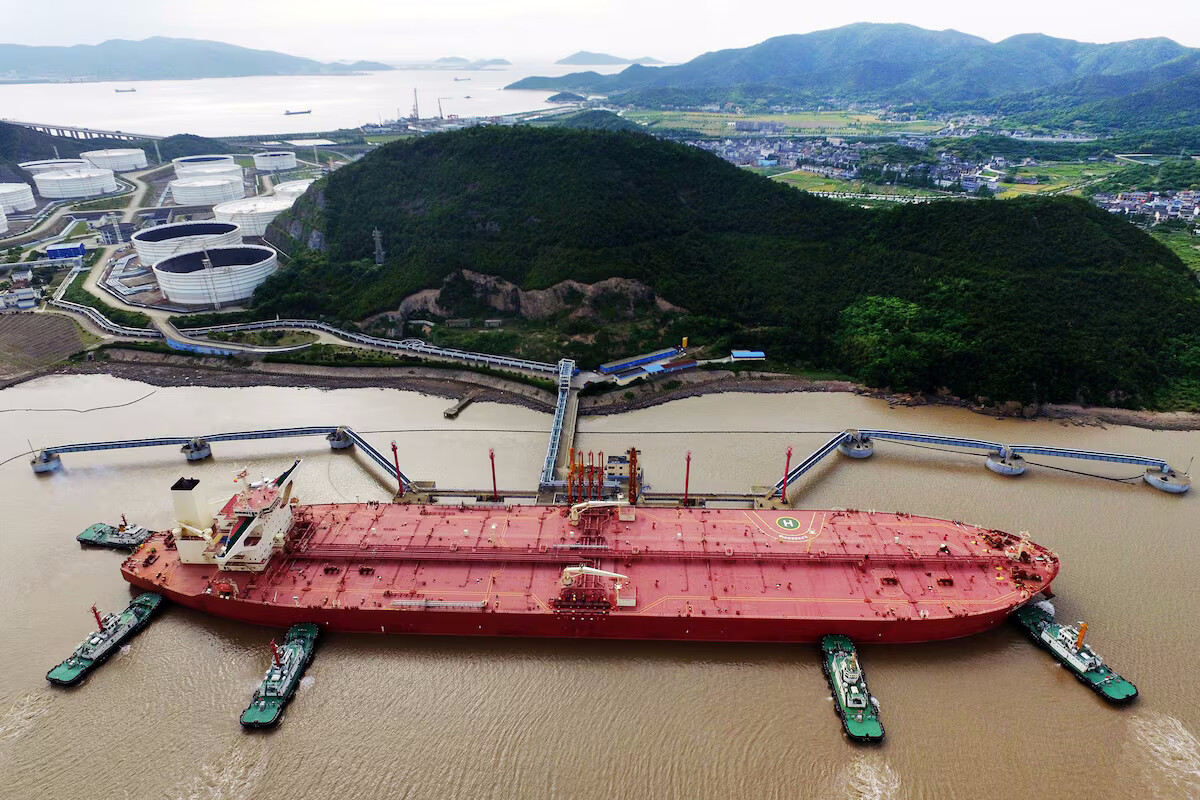
Иран тайно получил причалы и нефтехранилища в Китае, чтобы обходить американские санкции — Iran International
Иран тайно получил контроль над несколькими причалами и нефтяными терминалами в Китае и взял в долгосрочную аренду крупные хранилища, чтобы продавать нефть в обход американских санкций, пишет Iran International. Издание ссылается на секретное письмо Хамида Борда, бывшего главы Национальной иранской нефтяной компании, который сейчас исполняет обязанности министра нефти.